Databricks データを操作する
Databricks データをプラットフォームにインポートしたら、Databricks のコストと使用状況の分析とモニタリングを開始できます。Databricks データは、1 時間単位で追跡およびレポートされます。
Databricks システムテーブル
コンソールは、次の Databricks システムテーブルと連携します。
| System Table | Description |
|---|---|
system.billing.usage | アカウント全体の、請求対象となるすべての使用状況のレコードを含みます。 |
system.billing.list_prices | SKU 価格の履歴ログです。SKU 価格に変更があるたびにレコードが追加されます。 |
system.compute.node_timeline | すべての all-purpose および jobs コンピュートリソースの利用状況メトリクスを取得します。 |
system.access.workspaces_latest | アカウント内のすべてのワークスペースに関するメタデータを含みます。 |
system.compute.clusters | 任意のクラスタについて、時間の経過に伴うコンピュート設定の完全な履歴を含みます。 |
system.compute.warehouses | 任意の SQL warehouse について、時間の経過に伴う設定の完全な履歴を含みます。 |
system.serving.endpoint_usage | トークン数を含め、モデルサービング endpoint への各リクエストを記録します。DoiT は個々のリクエストではなく日次合計を保存します。オプションであり、GenAI Intelligence でのトークン使用データを有効にします。 |
system.serving.served_entities | モデルサービング endpoint にデプロイされたエンティティに関するメタデータを含み、endpoint 名からモデル名を解決するために使用されます。オプションであり、GenAI Intelligence でのトークン使用データを有効にします。 |
必要な権限は、DoiT コネクタ用のサービスプリンシパルを作成するときに付与されます。serving テーブルは任意です。トークン使用データを有効にするを参照してください。
Cloud Analytics における Databricks データ
ディメンションとメトリクスを通じて Databricks データを取得できます。DoiT と Databricks の用語の対応は以下を参照してください。
基本メトリクス
DoiT term | Databricks term | Description |
|---|---|---|
cost | cost | コンピュートワークロード(クラスタ、SQL warehouses など)によって消費された Databricks Units(DBUs)の合計コストと、基盤となるインフラストラクチャに対して選択したクラウドプロバイダーから別途請求される料金の合計です。 |
usage | usage | ワークロードやユーザーによって使用された Databricks コンピュートリソース(DBUs)および特定機能の消費量です。 |
標準ディメンション
| DoiT term | Description |
|---|---|
| Billing Account | 特定の Databricks アカウントの一意の識別子です。billing usage table schema の account_id に対応します。 |
| Project ID | Databricks warehouse の一意の識別子です。billing usage table schema の workspace_id に対応します。 |
| Project/Account name | Databricks workspace の名前です。workspaces system table schema の workspace_name に対応します。 |
| Usage start time | 記録された使用状況が発生した時間または請求間隔の開始時刻です。billing usage table schema の usage_start_time に対応します。 |
| Usage end time | 記録された使用状況が発生した請求間隔の終了時刻です。billing usage table schema の usage_end_time に対応します。 |
| Service ID/description | 請求対象となる使用状況の最終的な発生元となった特定の Databricks 製品または機能です。billing usage table schema の billing_origin_product に対応します。例:SQL、ALL_PURPOSE、INTERACTIVE。 |
| SKU ID/Description | 特定の使用レコードに対して消費され、コストを発生させた Stock Keeping Unit(SKU)です。billing usage table schema の usage_sku_name に対応します。例:STANDARD_ALL_PURPOSE_COMPUTE、SQL_CLASSIC_COMPUTE、ENTERPRISE_ALL_PURPOSE_COMPUTE_(PHOTON)。 |
| Report cost | 特定の使用単位に対する、ドル(または設定した通貨)での推定コストです。billing usage table schema の usage_quantity と、pricing table schema の pricing に対応します。 |
| Report usage | 記録された時間間隔中に、特定の Databricks 製品、機能、またはリソースが消費した単位数です。usage_quantity は usage_unit に依存します。たとえば、usage_unit が STORAGE_SPACE の場合、usage_quantity は TB-hours または GB-hours になります。billing usage table schema の usage_quantity に対応します。 |
| Usage unit | usage_quantity の測定単位です。billing usage table schema の usage_unit に対応します。例:DBU、STORAGE_SPACE、NETWORK_BYTE、API_OPERATION。 |
| Cost type | 使用レコードが元のエントリなのか、Databricks による修正に関連するものなのかを示します。billing usage table schema の record_type に対応します。例:ORIGINAL、RETRACTION、RESTATEMENT。 |
| Resource ID | コンピュート、ストレージ、またはデータを消費または管理する、Databricks 内のさまざまなオブジェクトまたはエンティティに割り当てられる一意の識別子です。 |
| Operation | プラットフォーム上で実行される Databricks のアクションまたはタスクであり、コンピュートリソースを消費し、DBUs で測定される料金を発生させます。 |
| Row ID | テーブル内の各使用レコード(行)に対する一意の識別子です。billing usage table schema の record_id に対応します。 |
システムラベル
以下は、プラットフォームで使用できる Databricks のシステムラベルです。
-
databricks/account_id: 特定の Databricks アカウントの一意の識別子。
-
databricks/cloud: Databricks warehouse が使用しているクラウドプロバイダー。例:
AWS、AZURE、GCP。 -
databricks/cluster_name: Databricks クラスタ名。
-
databricks/usage_type: DBUs を消費しているワークロードタイプまたは特定機能。例:
STORAGE_SPACE。 -
databricks/warehouse_name: Databricks warehouse 名。
Identity メタデータ
identity_metadata は、使用状況に関与するアイデンティティに関する追加情報を提供します。
-
databricks/identity_metadata/run_as: ワークロードを実行したユーザーを記録します。これらの値は、Identity metadata reference に記載されている特定のワークロードタイプに対してのみ設定されます。
-
databricks/identity_metadata/owned_by: SQL warehouse の使用にのみ適用され、その使用の原因となった SQL warehouse を所有するユーザーまたはサービスプリンシパルを記録します。
-
databricks/identity_metadata/created_by: Databricks Apps に適用され、アプリを作成したユーザーのメールアドレスを記録します。
使用メタデータ
usage_metadata の値は、利用レコードに関係するワークスペースのオブジェクトおよびリソースに関する文字列です。詳細は、Usage metadata reference を参照してください。
-
databricks/usage_metadata/cluster_id: コンピュートクラスタインスタンスのユニークな識別子。
-
databricks/usage_metadata/destination_region: データの転送先、またはリソースのレプリケーション先となる AWS もしくは Azure のリージョン。
-
databricks/usage_metadata/notebook_id: Databricks の利用に関連付けられたノートブックのユニークな識別子。
-
databricks/usage_metadata/dlt_pipeline_id: 利用レコードに関連付けられた宣言型パイプラインのユニークな識別子。
-
databricks/usage_metadata/dlt_update_id: 利用レコードに関連付けられたパイプライン更新のユニークな識別子。
-
databricks/usage_metadata/dlt_maintenance_id: 利用レコードに関連付けられたパイプライン保守タスクのユニークな識別子。
-
databricks/usage_metadata/run_name: 利用レコードに関連付けられた Foundation Model Fine-tuning 実行の、ユーザーに表示されるユニークな名前。
-
databricks/usage_metadata/notebook_path: 利用に関連付けられたノートブックのワークスペースストレージパス。
-
databricks/usage_metadata/central_clean_room_id: 利用レコードに関連付けられた central clean room のユニークな識別子。
-
databricks/usage_metadata/app_id: 利用レコードに関連付けられたアプリのユニークな識別子。
-
databricks/usage_metadata/budget_policy_id: ワークロードに紐付けられた serverless budget policy のユニークな識別子。
-
databricks/usage_metadata/endpoint_id: API エンドポイントのユニークな識別子。
-
databricks/usage_metadata/endpoint_name: Model Serving endpoint など、エンドポイントに付与される名前。
-
databricks/usage_metadata/job_id: Databricks ジョブに割り当てられるユニークな識別子。
-
databricks/usage_metadata/job_name: Databricks ジョブに付与される、ユーザー指定の人間が読みやすい名前。
-
databricks/usage_metadata/job_run_id: Databricks ジョブの特定の実行に割り当てられるユニークな識別子。
-
databricks/usage_metadata/metastore_id: Unity Catalog metastore のユニークな識別子。
-
databricks/usage_metadata/node_type: Databricks のクラスタノードに使用される、特定の仮想マシン (VM) インスタンスタイプ。
-
databricks/usage_metadata/source_region: データの送信元、またはリソースの初期配置場所となる AWS もしくは Azure のリージョン。
-
databricks/usage_metadata/warehouse_id: Databricks SQL warehouse のユニークな識別子。
製品機能リファレンス
product_features は、使用された特定の製品機能に関する情報を含むオブジェクトで、次のキーと値のペアを含みます。
-
databricks/product_features/jobs_tier: 値には
LIGHT、CLASSIC、またはnullが含まれます。 -
databricks/product_features/sql_tier: 値には
LIGHT、CLASSIC、またはnullが含まれます。 -
databricks/product_features/dlt_tier: 値には
CORE、PRO、ADVANCED、またはnullが含まれます。 -
databricks/product_features/is_serverless: 値には
trueまたはfalse、もしくはnullが含まれます。 -
databricks/product_features/is_photon: 値には
trueまたはfalse、もしくはnullが含まれます。 -
databricks/product_features/serving_type: 値には
MODEL、GPU_MODEL、FOUNDATION_MODEL、FEATURE、またはnullが含まれます。 -
databricks/product_features/offering_type: 値には
BATCH_INFERENCEまたはnullが含まれます。 -
databricks/product_features/networking_connectivity_type: 値には
PUBLIC_IPおよびPRIVATE_IPが含まれます。
拡張メトリクス
DoiT は Databricks の Cluster CPU utilization と Cluster memory utilization メトリクスをサポートしています。これらは Extended metrics の下に表示されます。
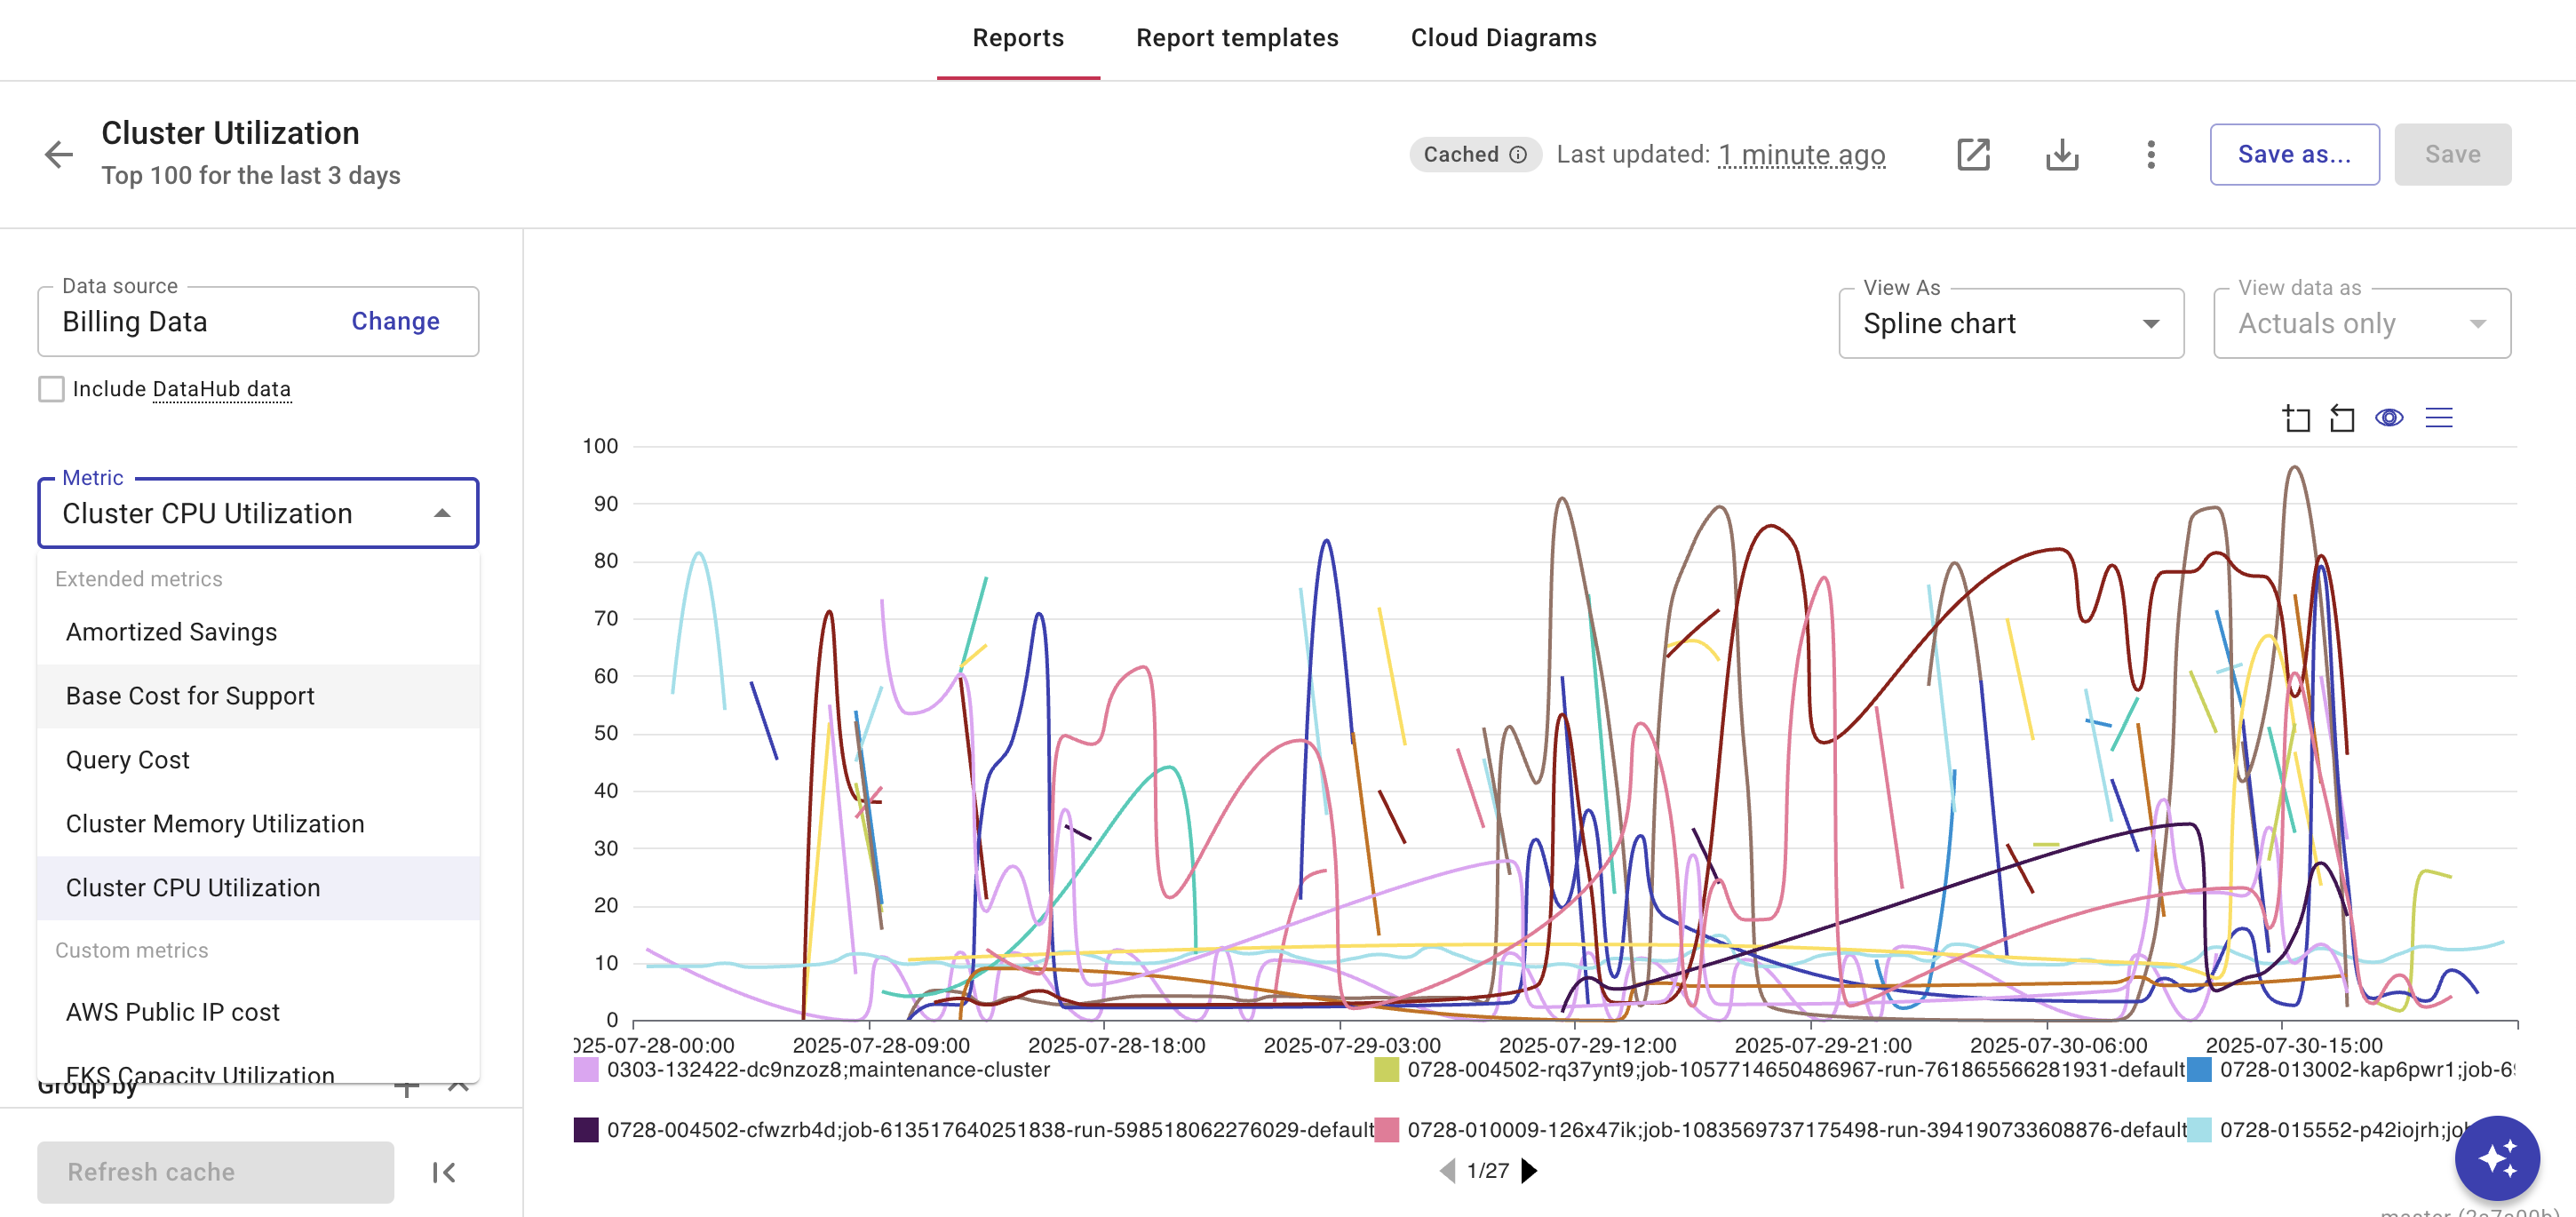
これらのメトリクスは、DBU コストを実行可能なインサイトに変換するために必要な運用コンテキストを提供します。例えば、クラスタで CPU やメモリ使用率が継続的に高い場合はボトルネックが存在することを示しており、そのワークロードに対してクラスタのプロビジョニングが不足している可能性があります。ノードを追加するか、コードの最適化が必要になることがあります。
Cluster CPU utilization
Cluster CPU utilization は、クラスタの CPU がタスク処理のためにアクティブに使用されている時間のパーセンテージを測定します。これはユーザーモード (ユーザーのワークロード)、システムモード (カーネル処理)、およびアイドル時間に分解されます。
Cluster memory utilization
Cluster memory utilization は、クラスタノード上で使用されている RAM のパーセンテージを測定します。Spark executor に割り当てられたメモリ、キャッシュされたデータ、およびシステムプロセスに使用されているメモリを追跡し、使用中、空きバッファ、キャッシュ済みメモリを区別します。